Wir planen, Entscheidungsmodelle wie Jev von TypeSafe einzusetzen. Ein Entscheidungsmodell schreibt keinen Text. Es bekommt eine Frage mit festen Antworten, etwa „Ist diese Zeile Pflicht, ja oder nein?“, und gibt für jede Antwort eine Wahrscheinlichkeit zurück. Unser Schwerpunkt ist souveräne KI: Die Daten bleiben auf eigener Hardware oder in der EU. Jev läuft laut TypeSafes Datenschutzerklärung in den USA, einen Standort in der EU nennt sie nicht. Deshalb wollen wir wissen, welche Alternativen es gibt und wie weit sie heute tragen. Wir haben Jev mit vier offenen Sprachmodellen verglichen, die auf unserer eigenen Grafikkarte laufen. Am 8. Oktober kam ein Klassifikator dazu, GLiNER2.5 Decide von Fastino. Bei Tempo und Kosten liegt Jev vorn, das zeigen schon die Laufdaten. Wir haben uns deshalb auf die Qualität der einzelnen Urteile konzentriert, denn dort entscheidet sich, ob ein lokales Modell mithalten kann.
Als Testfall dient der Projekt-Abgleich auf meiner Website. Er vergleicht eine Ausschreibung Zeile für Zeile mit meinem Lebenslauf. Wir haben ihn gewählt, weil er viele Facetten hat. Er stellt Ja-Nein-Fragen, wählt aus acht Bereichen, sucht einen Beleg aus einer Liste und vergibt eine Stufe von 0 bis 3, auf Deutsch und auf Englisch.
Die kurze Antwort: Zwei offene Modelle kommen nah an Jev heran, jedes auf einem anderen Gebiet. Qwen3.8-27B nennt am seltensten einen Beleg, den es im Lebenslauf nicht gibt. Winnow-12B liegt bei keiner der fünf Fragen messbar hinter Jev (statistisch geprüft, Erklärung unten). Gleich gut ist es damit nicht, dafür ist die Stichprobe zu klein: zehn erfundene Paare aus Ausschreibung und Lebenslauf, je Sprache rund 140 Zeilen. Jev ist je Zeile rund sieben- bis zehnmal so schnell, solange die lokalen Modelle ihre Fragen nacheinander beantworten, und günstiger, sobald man die Hardware mitrechnet. Der Klassifikator GLiNER2.5 Decide, dessen Hersteller sich selbst mit Jev vergleicht, schneidet im Mittel nicht besser ab, als wenn man jeder Zeile die häufigste Antwort gibt. Und was „richtig“ ist, haben bisher Sprachmodelle als Richter festgelegt, kein Mensch.
Der Testfall in fünf Fragen
Der Abgleich stellt je Zeile der Ausschreibung fünf kleine Fragen mit festen Antworten. Ein Beispiel aus unserem Prüfstand, der alle Modelle mit denselben Fällen misst. Eine Ausschreibung für ein Kundenportal enthält die Zeile „Einsatz von KI zur Erzeugung und Pflege von Testfällen aus Anforderungen“. Der Lebenslauf daneben gehört einem erfahrenen Testautomatisierer, der ein Projekt „Testfallentwürfe mit einem LLM“ nennt. Die rechte Spalte zeigt, was die Referenz für diese Zeile festlegt.
| # | Frage | Antworten | Im Beispiel |
|---|---|---|---|
| 1 | Ist die Zeile eine Anforderung? | ja oder nein | ja |
| 2 | Ist sie Pflicht? | ja oder nein | ja |
| 3 | Zu welchem von acht Bereichen gehört sie? | eines von acht oder „keiner davon“ | KI und LLMs |
| 4 | Welcher Eintrag im Lebenslauf belegt sie? | ein Eintrag oder „keiner“ | das Projekt „Testfallentwürfe mit einem LLM“ |
| 5 | Wie gut ist sie abgedeckt? | Stufe 0 bis 3 | Stufe 2 |
Dazu kommen Fragen zur ganzen Ausschreibung und zum ganzen Lebenslauf. Je Modell und Lauf sind das 1575 Fragen: fünf je Zeile bei 275 Zeilen in beiden Sprachen, dazu 72 zu den Ausschreibungen und 128 zu den Lebensläufen.
Zwei Begriffe kommen unten oft vor. Der Beleg ist die Antwort auf Frage 4. Nennt ein Modell einen Eintrag, obwohl keiner die Anforderung zeigt, nennen wir das einen erfundenen Beleg. Die Stufe ist die Antwort auf Frage 5, je höher, desto besser abgedeckt.
Wer festlegt, was richtig ist
Jede Quote unten misst die Übereinstimmung mit einer Referenz, einer Musterlösung je Zeile. Sie stammt bisher nicht von Menschen, sondern von Claude-Modellen der Firma Anthropic. Alle urteilten blind, ohne eine Modellantwort zu sehen. Claude Opus hat am 1. Oktober 2026 die deutschen Zeilen beurteilt und in einem eigenen Lauf die englischen. Richter aus einer Modellfamilie können denselben blinden Fleck haben. Deshalb haben Claude Sonnet und Claude Fable am 2. Oktober das deutsche Urteil gegengeprüft. Alle drei sind sich bei 575 von 636 Einzelfragen einig, das sind 90,4 Prozent.
Die 61 Streitfälle hat je ein frisch gestarteter Agent entschieden. Er durfte im Netz recherchieren, musste Quellen nennen und sah keine Modellantwort. Danach haben 48 statt 43 Anforderungen keinen Beleg, und 13 Stufen liegen eins höher. Das Ergebnis nennen wir die abgestimmte Referenz. Die deutschen Zahlen gelten gegen sie, die englischen gegen das Urteil von Opus allein. Ganz unabhängig ist die Referenz nicht, denn die Entscheider sind dieselben Modelle wie die Gegenprüfer. Einen Hang zur eigenen Familie zeigt die Auswertung nicht: Fables abweichende Urteile setzten sich bei beiden Entscheidern etwa zur Hälfte durch, die von Sonnet bei beiden selten. Bevor wir ein Modell gut genug nennen, beurteilt ein Mensch eine Stichprobe.
Die Ergebnisse
Das Bild zeigt alle sechs Modelle nebeneinander auf denselben Skalen. Jev ist blau, die lokalen Modelle grau. Unter jedem Titel steht, auf wie vielen Zeilen die Quote beruht.
Sechs Modelle, dieselben 136 deutschen Zeilen
▲ abgesichert besser als Jev · ▼ abgesichert schlechter als Jev · ohne Zeichen: kein abgesicherter Abstand
| Jev | 81,0 % |
|---|---|
| Winnow-12B | 85,3 % |
| Qwen3.8-27B | 87,9 % |
| Shisa DE-1 | 79,3 % |
| Qwen3-32B | 77,6 % |
| GLiNER2.5-Decide-1B | 13,8 %, abgesichert schlechter als Jev |
| Jev | 25,0 % |
|---|---|
| Winnow-12B | 18,8 % |
| Qwen3.8-27B | 10,4 %, abgesichert besser als Jev |
| Shisa DE-1 | 35,4 % |
| Qwen3-32B | 33,3 % |
| GLiNER2.5-Decide-1B | 100,0 %, abgesichert schlechter als Jev |
| Jev | 79,3 % |
|---|---|
| Winnow-12B | 77,6 % |
| Qwen3.8-27B | 69,0 %, abgesichert schlechter als Jev |
| Shisa DE-1 | 66,4 %, abgesichert schlechter als Jev |
| Qwen3-32B | 47,4 %, abgesichert schlechter als Jev |
| GLiNER2.5-Decide-1B | 36,2 %, abgesichert schlechter als Jev |
| Jev | 93,1 % |
|---|---|
| Winnow-12B | 87,1 % |
| Qwen3.8-27B | 86,2 %, abgesichert schlechter als Jev |
| Shisa DE-1 | 85,3 %, abgesichert schlechter als Jev |
| Qwen3-32B | 76,7 %, abgesichert schlechter als Jev |
| GLiNER2.5-Decide-1B | 51,7 %, abgesichert schlechter als Jev |
| Jev | 93,1 % |
|---|---|
| Winnow-12B | 94,0 % |
| Qwen3.8-27B | 97,4 % |
| Shisa DE-1 | 75,9 %, abgesichert schlechter als Jev |
| Qwen3-32B | 100,0 %, abgesichert besser als Jev |
| GLiNER2.5-Decide-1B | 94,0 % |
| Jev | 0,25 s |
|---|---|
| Winnow-12B | 2,49 s |
| Qwen3.8-27B | 1,76 s |
| Shisa DE-1 | 2,35 s |
| Qwen3-32B | 1,65 s |
| GLiNER2.5-Decide-1B | 0,26 s |
Die Quoten von Jev und den vier Sprachmodellen als Netz, dazu das Tempo. GLiNER steht nur in den Tabellen. Jede Achse reicht von 0 bis 100 Prozent, je weiter außen, desto besser. So sieht man auf einen Blick, wo Jev vorn liegt und wo die lokalen Modelle ihre Spitzen haben. Über die Legende lässt sich jedes Modell ausblenden.
Wo jedes Modell vorn liegt
Sieben Achsen von 0 bis 100 Prozent, je weiter außen, desto besser. Ein Ring markiert den höchsten Wert je Achse.
Tempo ist relativ: 100 % ist die schnellste Zeit. Darum prägt Tempo die Fläche stark.
Modelle ein- und ausblenden
Höchster Wert je Achse: Jev bei Tempo (relativ), Stufe genau, Bereich und Anforderung erkannt. Qwen3.8-27B bei Kein erfundener Beleg und Beleg. Qwen3-32B bei Pflicht.
Zeigen Sie auf eine Achse oder tippen Sie sie an, mit der Tastatur über die Tabulatortaste. Dann stehen hier die Werte.
Alle Werte als Tabelle
| Modell | Tempo (relativ) | Stufe genau | Bereich | Anforderung erkannt | Kein erfundener Beleg | Beleg | Pflicht | Zeit je Zeile |
|---|---|---|---|---|---|---|---|---|
| Jev | 100,0 % | 79,3 % | 93,1 % | 88,2 % | 75,0 % | 81,0 % | 93,1 % | 0,25 s |
| Winnow-12B | 10,0 % | 77,6 % | 87,1 % | 86,8 % | 81,2 % | 85,3 % | 94,0 % | 2,49 s |
| Qwen3.8-27B | 14,2 % | 69,0 % | 86,2 % | 85,3 % | 89,6 % | 87,9 % | 97,4 % | 1,76 s |
| Shisa DE-1 | 10,6 % | 66,4 % | 85,3 % | 85,3 % | 64,6 % | 79,3 % | 75,9 % | 2,35 s |
| Qwen3-32B | 15,2 % | 47,4 % | 76,7 % | 85,3 % | 66,7 % | 77,6 % | 100,0 % | 1,65 s |
„Abgesichert“ heißt im ersten Bild: Wir haben jeden Abstand zu Jev Zeile für Zeile mit einem statistischen Test geprüft, wie im Artikel „Jev im Praxistest“. Der Test zählt nur die Zeilen, auf denen eines der beiden Modelle richtig liegt und das andere falsch. Liegt sein Wert p unter 0,05, ist ein so großer Unterschied selten reiner Zufall. Ein Wert darüber beweist umgekehrt keine Gleichheit.
Die folgenden Absätze vergleichen Jev mit den vier Sprachmodellen. GLiNER hat einen eigenen Abschnitt weiter unten.
Beim Beleg liegt Qwen3.8-27B mit 87,9 Prozent vorn, vor Winnow-12B (85,3) und Jev (81,0). Abgesichert ist keiner der beiden Abstände. Klar ist dagegen der Unterschied beim erfundenen Beleg. Laut Referenz haben 48 Anforderungen keinen Beleg im Lebenslauf. Bei 12 davon nennt Jev trotzdem einen Eintrag, Qwen3.8-27B bei 5, und bei diesen fünf Zeilen nennt auch Jev einen. Dieser Abstand ist abgesichert (p = 0,016). Einen vorhandenen Beleg übersieht Qwen3.8-27B bei 2 von 68 Zeilen, Jev bei 1.
Bei der Stufe liegt Jev mit 79,3 Prozent vorn, Winnow-12B folgt mit 77,6 ohne abgesicherten Abstand (p = 0,824). Die anderen drei liegen abgesichert dahinter, Qwen3.8-27B mit 69,0 Prozent (p = 0,036). Höchstens eine Stufe daneben liegen alle fünf bei 95 bis 100 Prozent. Grobe Fehlgriffe wie 0 statt 3 sind selten.
Beim Bereich ist Jev ebenfalls vorn, mit 108 von 116 Anforderungen. Gegen Qwen3.8-27B, Shisa DE-1 und Qwen3-32B ist das abgesichert. Gegen Winnow-12B nicht: Jev liegt bei 9 Zeilen richtig, auf denen Winnow-12B falsch liegt, umgekehrt sind es 2 (p = 0,065).
Bei der Pflicht liegt Qwen3-32B mit 100 Prozent abgesichert vor Jev (93,1). Qwen3.8-27B (97,4) und Winnow-12B (94,0) liegen ebenfalls vorn, aber ohne abgesicherten Abstand. Shisa DE-1 fällt mit 75,9 Prozent deutlich ab. Ob eine Zeile überhaupt eine Anforderung ist, erkennen alle fünf in 85 bis 89 Prozent der Zeilen. Die Abweichungen sind fast alle Titel- und Rahmenzeilen wie Laufzeit oder Ort.
Bei Tempo und Kosten liegt Jev vorn. Je Zeile braucht es 0,25 Sekunden gegen 1,65 bis 2,49 Sekunden lokal. Jev beantwortet die fünf Fragen einer Zeile in einer Anfrage. Lokal liefen sie nacheinander auf einer einzelnen Grafikkarte RTX 4090. Ob sie gleichzeitig schneller gehen, haben wir für diese Fragen nicht gemessen. (Nachtrag vom 12. Oktober 2026: Der Fähigkeitstest C8 misst das inzwischen für kurze Entscheidungen mit einem Token, mit bis zu 16 parallelen Anfragen und dem Stromverbrauch der Karte, Befund C8.) 1.000 Zeilen kosten bei Jev zum Listenpreis rund 7 US-Cent. Lokal kostet allein der Strom grob 7 bis 11 Cent. Das ist geschätzt aus der gemessenen Rechenzeit und der Höchstleistung der Grafikkarte, gemessen haben wir den Stromverbrauch nicht. Die Hardware ist dabei noch nicht gerechnet. Lokal lohnt sich also dort, wo Daten das Haus nicht verlassen dürfen, nicht beim Preis.
Alle deutschen Werte als Tabelle:
| # | Modell | Anforderung erkannt | Pflicht | Bereich | Beleg | Beleg erfunden | Stufe genau | Stufe höchstens eins daneben | Zeit je Zeile |
|---|---|---|---|---|---|---|---|---|---|
| 1 | Jev | 88,2 % | 93,1 % | 93,1 % | 81,0 % | 25,0 % | 79,3 % | 98,3 % | 0,25 s |
| 2 | Winnow-12B | 86,8 % | 94,0 % | 87,1 % | 85,3 % | 18,8 % | 77,6 % | 98,3 % | 2,49 s |
| 3 | Qwen3.8-27B | 85,3 % | 97,4 % | 86,2 % ▼ | 87,9 % | 10,4 % ▲ | 69,0 % ▼ | 100,0 % | 1,76 s |
| 4 | Shisa DE-1 | 85,3 % | 75,9 % ▼ | 85,3 % ▼ | 79,3 % | 35,4 % | 66,4 % ▼ | 95,7 % | 2,35 s |
| 5 | Qwen3-32B | 85,3 % | 100,0 % ▲ | 76,7 % ▼ | 77,6 % | 33,3 % | 47,4 % ▼ | 95,7 % | 1,65 s |
| 6 | GLiNER2.5-Decide-1B | 72,1 % ▼ | 94,0 % | 51,7 % ▼ | 13,8 % ▼ | 100,0 % ▼ | 36,2 % ▼ | 82,8 % ▼ | 0,26 s |
Deutsche Zeilen, erster Lauf vom 1. Oktober 2026, bei GLiNER vom 8. Oktober 2026, gegen die abgestimmte Referenz vom 2. Oktober 2026. „Anforderung erkannt“ zählt über alle 136 Zeilen, Pflicht, Bereich, Beleg und Stufe über die 116 Anforderungen, „Beleg erfunden“ über die 48 Anforderungen ohne Beleg. „Stufe höchstens eins daneben“ zählt auch eine Antwort als richtig, die eine Stufe neben der Referenz liegt. Bei „Beleg erfunden“ und „Zeit je Zeile“ ist weniger besser. Zeit je Zeile ist der Median über die 136 Zeilen. ▲ abgesichert besser als Jev, ▼ abgesichert schlechter als Jev (p < 0,05).
Die Referenz macht dabei einen Unterschied. Gegen das Urteil von Opus allein lag Winnow-12B beim Beleg vorn und beim Bereich abgesichert hinter Jev (p = 0,021), und alle Stufen-Quoten lagen 5 bis 6 Punkte tiefer.
Die englischen Zeilen
Die englischen Zeilen zählen gegen das Urteil von Opus allein, ohne Gegenprüfung. Die Tabelle hat denselben Aufbau.
| # | Modell | Anforderung erkannt | Pflicht | Bereich | Beleg | Beleg erfunden | Stufe genau | Stufe höchstens eins daneben | Zeit je Zeile |
|---|---|---|---|---|---|---|---|---|---|
| 1 | Jev | 88,5 % | 89,1 % | 91,6 % | 79,0 % | 27,3 % | 74,8 % | 99,2 % | 0,25 s |
| 2 | Winnow-12B | 89,2 % | 97,5 % ▲ | 88,2 % | 81,5 % | 20,5 % | 70,6 % | 98,3 % | 2,47 s |
| 3 | Qwen3.8-27B | 85,6 % | 97,5 % ▲ | 81,5 % ▼ | 82,4 % | 9,1 % ▲ | 63,9 % ▼ | 100,0 % | 1,73 s |
| 4 | Shisa DE-1 | 85,6 % | 63,0 % ▼ | 86,6 % | 81,5 % | 31,8 % | 63,0 % ▼ | 94,1 % ▼ | 2,33 s |
| 5 | Qwen3-32B | 85,6 % | 100,0 % ▲ | 71,4 % ▼ | 78,2 % | 31,8 % | 47,1 % ▼ | 95,8 % | 1,60 s |
| 6 | GLiNER2.5-Decide-1B | 67,6 % ▼ | 94,1 % | 62,2 % ▼ | 1,7 % ▼ | 100,0 % ▼ | 36,1 % ▼ | 63,0 % ▼ | 0,21 s |
Englische Zeilen, erster Lauf vom 1. Oktober 2026, bei GLiNER vom 8. Oktober 2026, gegen das Urteil von Claude Opus vom 1. Oktober. 139 Zeilen, davon 119 Anforderungen, 44 davon ohne Beleg. Zeit je Zeile ist der Median über die 139 Zeilen. ▲ abgesichert besser als Jev, ▼ abgesichert schlechter als Jev (p < 0,05).
Die englischen Zeilen bestätigen den erfundenen Beleg: Jev nennt bei 12 von 44 Zeilen ohne Beleg einen Eintrag, Qwen3.8-27B bei 4 (p = 0,008). Einen vorhandenen Beleg übersieht Qwen3.8-27B englisch dafür öfter, bei 8 von 75 Zeilen, Jev bei 4. Bei der Stufe liegt Qwen3.8-27B auch englisch abgesichert hinter Jev (p = 0,019), Winnow-12B nicht (p = 0,442). Anders ist die Pflicht: Englisch liegen Winnow-12B und Qwen3.8-27B abgesichert vor Jev, mit je 10 gegen 0 Zeilen (p = 0,002).
Nachtrag vom 8. Oktober 2026: GLiNER2.5 Decide
Im September 2026 hat Fastino die Klassifikatoren GLiNER2.5 Decide veröffentlicht. In der Vergleichstabelle auf seiner Modellkarte steht Jev unter dem Namen „JevK5“. Auf Fastinos eigenem englischem Datensatz für schnelle Entscheidungen kommt Decide dort auf 60,2 Prozent, JevK5 auf 57,6 Prozent. Ein neues Modell, das sich selbst mit Jev vergleicht, wollten wir im selben Prüfstand sehen.
GLiNER ist kein Sprachmodell. Es bekommt einen Text und eine Liste von Etiketten und gibt je Etikett eine Wahrscheinlichkeit zurück. Text schreibt es nicht. Wir haben alle drei Modelle der Reihe gemessen: multi-Decide mit 287 Millionen Parametern für viele Sprachen, Decide mit 340 Millionen und Decide-1B mit rund einer Milliarde, beide für Englisch. Jede Frage ging als eigene Klassifikationsaufgabe hinein. Die Etiketten sind die Antworten der Frage, ihre Beschreibungen die Antworttexte aus Jevs Anfrage.
Zwei Anpassungen hat das Modell erzwungen. GLiNER lehnt runde Klammern in Aufgabe und Etiketten ab, weil es sie selbst als Markierung nutzt. Wir haben sie durch eckige ersetzt. Beim Beleg bestehen die Antworten nur aus Verweisen wie cv.s-x. Ein Klassifikator kann einen Verweis nicht nachschlagen, deshalb bekam jede Belegantwort den Text ihres Lebenslaufeintrags als Beschreibung.
Die Frage lässt sich auf drei Arten übergeben:
- als Aufgabentext, so wie die Modellkarte Fragen an einen Text zeigt,
- an den Text angehängt, so wie die Sprachmodelle sie bekommen,
- als Aufgabentext zu einem gekürzten Text, der nur die Abschnitte enthält, die die Frage nennt.
Die beiden letzten Arten haben wir ergänzt, weil eine Probe vorher zeigte, dass das Modell den Aufgabentext kaum liest. Am Beispiel der Modellkarte („The treaty was signed in Paris in 1992. It entered into force the following year“) gab multi-Decide auf „Did the treaty enter into force in 1992?“ und auf dieselbe Frage mit 1993 beide Male 0,993 für ja. Decide und Decide-1B verhielten sich genauso. Drei Modelle mal drei Arten ergeben neun Varianten, je ein Lauf am 8. Oktober 2026 auf derselben RTX 4090. Ein Klassifikator zieht beim Antworten keine Stichprobe. Ein zweiter Lauf sollte dasselbe ergeben, gemacht haben wir ihn nicht.
Die beste der neun Varianten ist Decide-1B mit gekürztem Text, sie steht als sechste Zeile in beiden Tabellen. Im Mittel der fünf Zeilenfragen erreicht sie deutsch 53,6 Prozent und englisch 52,3 Prozent, Jev 86,9 und 84,6 Prozent. Wer jeder Zeile einfach die häufigste Antwort der Referenz gibt, ohne ein Modell zu fragen, kommt auf 54,3 und 53,4 Prozent. Nah an Jev liegt diese Variante nur bei der Pflicht, andere Varianten auch bei der Anforderung. Das gelingt nur, weil die Referenz dort bei 94 und 85 Prozent der Zeilen ja sagt.
„Kein Beleg“ wählt keine der neun Varianten je. Jede Anforderung ohne Beleg bekommt einen erfundenen Eintrag, der erfundene Beleg steht deshalb bei 100 Prozent. Den richtigen Beleg treffen die neun Varianten bei 2 bis 19 Prozent der Anforderungen. Immer „kein Beleg“ zu antworten wäre deutsch bei 41 Prozent richtig, englisch bei 37 Prozent. Auch der Gesamtwert des Abgleichs trennt passende und unpassende Paare nicht: Die drei unpassenden Paare bekommen von den GLiNER-Varianten 31 bis 91 Punkte, von Jev 12 bis 34.
Teilweise gelingt nur der Bereich. Einen kurzen Text einem Thema zuzuordnen, ist die Aufgabe, für die GLiNER gebaut ist. Mit gekürztem Text erreicht Decide-1B deutsch 51,7 und englisch 62,2 Prozent. Jev liegt bei 93,1 und 91,6 Prozent, die vier Sprachmodelle bei 71 bis 88 Prozent. Der Abstand zu Jev ist abgesichert: Deutsch liegt nur Jev auf 50 Zeilen richtig, nur GLiNER auf 2 (p < 0,001).
Schnell ist GLiNER. Für eine deutsche Zeile braucht Decide-1B mit gekürztem Text 0,26 Sekunden, fünf Fragen nacheinander. Über alle neun Varianten sind es 0,13 bis 0,41 Sekunden. Jev beantwortet eine Zeile in einer Anfrage in 0,25 Sekunden, die Sprachmodelle brauchen 1,65 bis 2,49 Sekunden. Das Tempo nützt nur wenig, solange die Antworten nicht stimmen.
Wie wir das lesen: GLiNER2.5 Decide ist, was die Modellkarte beschreibt. Es ordnet einen Text einer Liste von Etiketten zu, etwa nach Absicht, Thema oder Stimmung. Der Abgleich fragt etwas anderes, nämlich ob ein zweiter Text zeigt, was der erste verlangt. Dafür müssen beide Texte gegeneinander abgewogen werden, und das leistet keines der drei Modelle auf einer der drei Arten. Ein nachtrainiertes GLiNER wäre eine andere Frage. Fastino bietet Training an, getestet haben wir das nicht. Fastinos Tabelle misst eine andere Aufgabe auf einem eigenen englischen Datensatz, mit einer Jev-Fassung, die wir nicht kennen. Bei uns lief jev-1.13.0. Beide Ergebnisse können stimmen.
Selbst ausprobieren im Labor
Die Zahlen oben sind Anteile über viele Zeilen. Wie eine einzelne Entscheidung zustande kommt, sieht man besser selbst. Unter bks-lab.com/labor/entscheidungsmodelle laufen die gespeicherten Antworten aus dem Prüfstand ab. Aus Ihrem Browser geht dabei keine Anfrage an ein Modell hinaus. Drei Versuche für den Einstieg:
- Ein Beleg, den es nicht gibt. Wählen Sie im Experiment „Wer trifft den Richter?“ den Fall „Erfahrung mit Agenten-Frameworks und Tool-Anbindung“. Tippen Sie zuerst, ob der Lebenslauf dafür einen Eintrag hat. Er hat keinen. Jev nennt trotzdem mit 0,90 das Projekt „Testfallentwürfe mit einem LLM“. Qwen3.8-27B wählt knapp „kein Beleg“, mit 0,50 gegen 0,45.
- Eine Sicherheit, die keine ist. Wählen Sie im Abschnitt „Weg einer Entscheidung“ den Fall „Das Modell will etwas anderes schreiben“ und das Modell Winnow-12B. Nur 0,07 der Wahrscheinlichkeit liegen auf einem Antwortbuchstaben. Nach dem Umrechnen steht trotzdem 0,98 für ja. Schalten Sie danach auf Jev und vergleichen Sie.
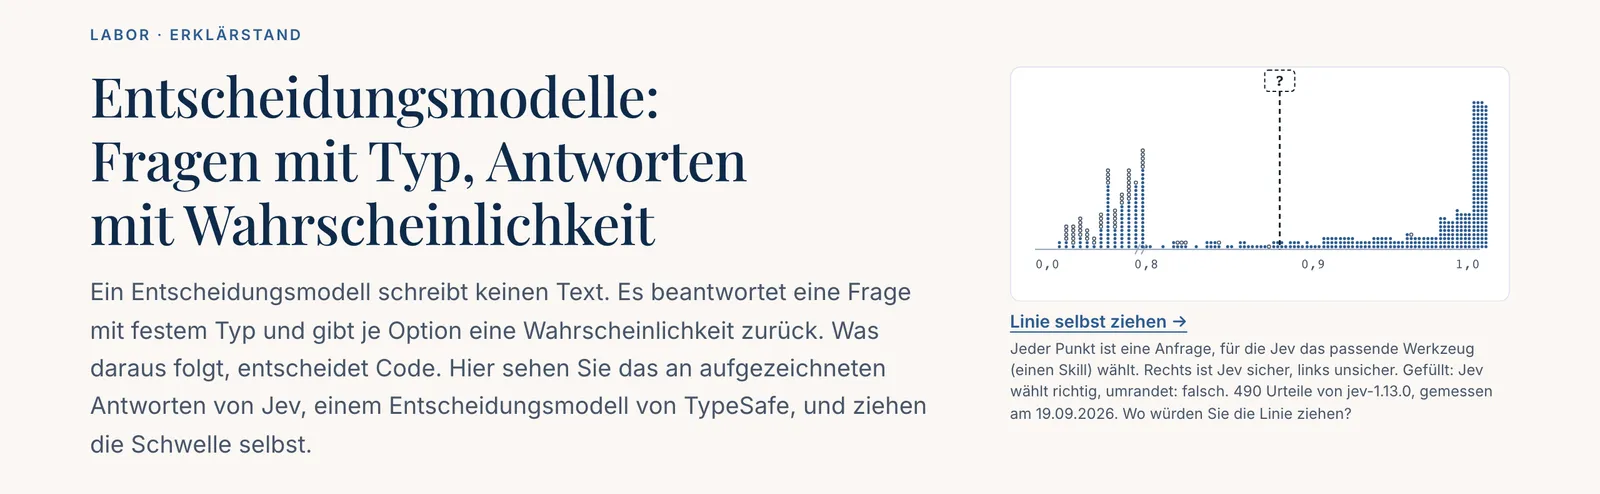
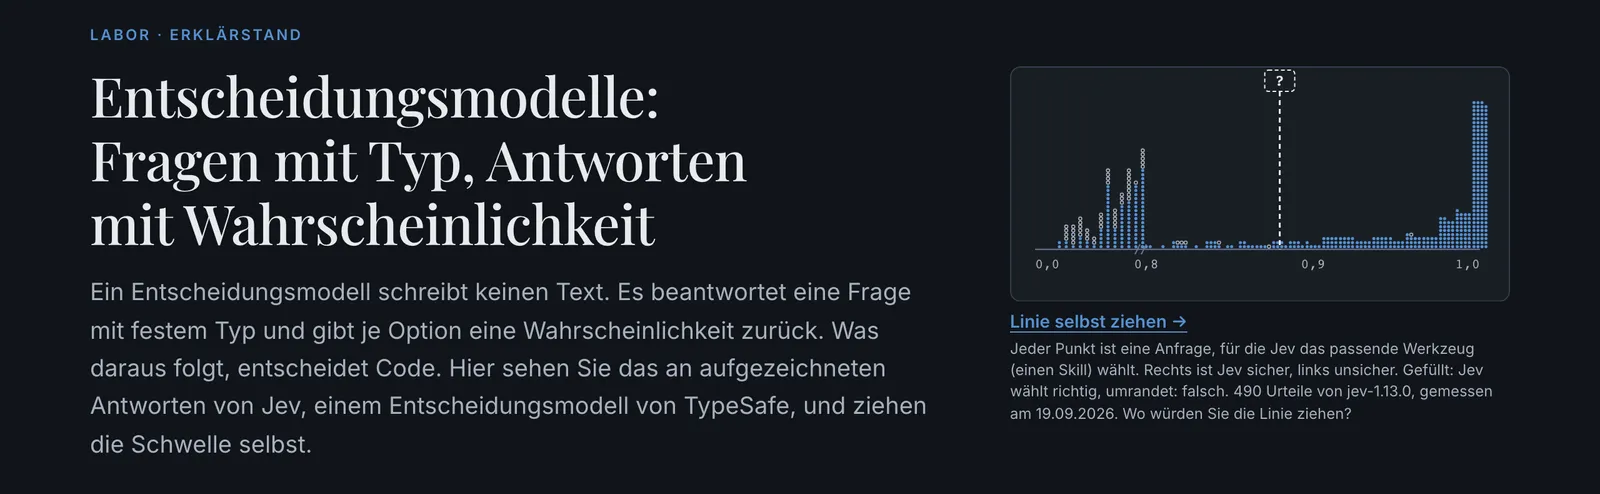
- Die eigene Linie ziehen. Eine Schwelle ist die Wahrscheinlichkeit, ab der Code eine Antwort ohne Menschenblick übernimmt. Im Experiment „Wo setzt der Code die Schwelle?“ tippen Sie zuerst, wo sie liegen sollte, und ziehen die Linie dann selbst. Die Seite zeigt rot, was Code dabei falsch entscheidet. Die Daten dort stammen aus dem Artikel „Jev im Praxistest“.
Was daraus folgt
Das läuft schon lokal. Winnow-12B liegt bei keiner der fünf Fragen abgesichert hinter Jev. Mit 12 Milliarden Parametern ist es das kleinste der vier Modelle und läuft auf einer einzelnen Grafikkarte. Keine nachweisbare Abweichung ist aber keine nachgewiesene Gleichheit, dafür sind 116 Anforderungen zu wenige. Bei einzelnen Fragen ist ein lokales Modell schon gleich gut oder besser. Qwen3.8-27B erfindet abgesichert seltener einen Beleg als Jev, bei 5 statt 12 von 48 Anforderungen ohne Beleg. Einen vorhandenen übersieht es deutsch bei 2 von 68 Zeilen gegen 1, englisch bei 8 von 75 gegen 4. Bei der Pflicht liegt Qwen3-32B abgesichert vor Jev. Wer lokal arbeitet, kann je Frage ein anderes Modell wählen oder ein zweites als Gegenprobe fragen.
Hier bleibt Jev vorn. Bei Tempo und Kosten klar, je Zeile ist es rund sieben- bis zehnmal so schnell und mit Hardware gerechnet günstiger. Bei Stufe und Bereich liegt es abgesichert vor den beiden Qwen-Modellen und Shisa DE-1, vor Winnow-12B nicht abgesichert. Wer heute ein einziges Modell für alle fünf Fragen braucht, ist in diesem Vergleich mit Jev am besten bedient. Fehlerfrei ist auch Jev nicht: Bei 12 von 48 Anforderungen ohne Beleg nennt es trotzdem einen Eintrag.
Ein Mensch muss jeden Beleg nachprüfen können. Jev und jedes der vier Sprachmodelle erfinden manchmal einen Beleg, zwischen 10,4 und 35,4 Prozent der Anforderungen ohne Beleg. GLiNER tut es bei jeder. Eine Anwendung muss deshalb jeden genannten Beleg sichtbar zeigen, bei Jev genauso wie bei einem lokalen Modell.
Ein Klassifikator für einzelne Texte ersetzt das Abwägen nicht. GLiNER2.5 Decide sortiert einen Text in Etiketten. Für den Abgleich reicht das nicht, denn er muss zwei Texte gegeneinander lesen. Eine eigene Vergleichstabelle des Herstellers sagt über die eigene Aufgabe wenig, messen muss man sie selbst.
Gemessen wird gegen eine eigene Referenz, nicht gegen Jev. Über alle 1575 Fragen gibt Winnow-12B in 88,6 Prozent der Fälle dieselbe Antwort wie Jev, öfter als jedes andere lokale Modell. Das misst Ähnlichkeit, nicht Richtigkeit. Erst die Referenz zeigt, dass Qwen3.8-27B seltener einen Beleg erfindet als Jev selbst.
Für den souveränen Einsatz ist noch offen:
- Was als Beleg zählt, muss feststehen, dann beurteilt ein Mensch eine Stichprobe.
- Dieselben offenen Modelle bei einem Anbieter in der EU, mit Kosten je Aufgabe.
- Was der Betrieb auf eigener Hardware kostet.
- Die Kalibrierung der lokalen Modelle, also ob eine Sicherheit von 90 Prozent in 90 Prozent der Fälle stimmt.
Für Technikinteressierte: wie wir gemessen haben
Was Jev ist
TypeSafe nennt Jev ein System-One-Modell, trainiert auf kalibrierte Entscheidungen statt auf Text. Kalibriert heißt: Eine Sicherheit von 0,9 stimmt in neun von zehn Fällen. Aufbau, Größe und Trainingsdaten legt TypeSafe nicht offen. Für diesen Artikel zählt, wie Jev sich nach außen verhält.
Die Modelle
Keines der fünf offenen Modelle ist Jev. Winnow-12B und Shisa DE-1 sind Gemma-4-Modelle von Google, die andere Teams auf Entscheidungen mit festen Antworten nachtrainiert haben. Winnows Modellkarte sagt ausdrücklich, dass Winnow nicht mit TypeSafe verbunden ist. Qwen3.8-27B und Qwen3-32B sind allgemeine Sprachmodelle. GLiNER2.5-Decide-1B ist kein Sprachmodell, sondern ein Klassifikator ohne Textausgabe.
| # | Modell | Art | Herkunft | Basis | Lizenz | Lauf |
|---|---|---|---|---|---|---|
| 1 | Jev 1.13.0 | Entscheidungsmodell per API | TypeSafe | nicht veröffentlicht | kommerzielle API | API, 5 Läufe |
| 2 | Winnow-12B | offenes Sprachmodell, auf Entscheidungen nachtrainiert | EldanRing | Gemma 4 12B | Apache 2.0 | lokal, Q8_0 |
| 3 | Qwen3.8-27B | allgemeines Sprachmodell | Qwen | eigenes Modell | Apache 2.0 | lokal, Ollama-Tag qwen3.8:27b |
| 4 | Shisa DE-1 | offenes Sprachmodell, auf Entscheidungen nachtrainiert | shisa-ai | Gemma 4 26B-A4B (MoE) | Apache 2.0 | lokal, Q4_K_M |
| 5 | Qwen3-32B | allgemeines Sprachmodell | Qwen | eigenes Modell | Apache 2.0 | lokal, Ollama-Tag qwen3:32b, früherer Lauf am selben Tag |
| 6 | GLiNER2.5-Decide-1B | Klassifikator ohne Textausgabe, kein Sprachmodell | Fastino | Ettin-Encoder, rund 1 Milliarde Parameter | Apache 2.0 | lokal, gliner2 2.0.0, gekürzter Text, Lauf am 8. Oktober 2026 |
Lokal heißt: eine Grafikkarte RTX 4090 mit Ollama, einem Programm, das offene Modelle auf dem eigenen Rechner ausführt. Q8_0 und Q4_K_M sagen, wie stark die Gewichte komprimiert sind, damit das Modell auf die Karte passt: rund 8 und rund 5 Bit je Gewicht statt 16. GLiNER lief auf derselben Karte ohne Ollama, mit der Python-Bibliothek gliner2 von Fastino.
Der Prüfstand
Der Prüfstand gehört BKS-Lab und liegt in einem öffentlichen Repository, bks-lab/lab-bench, samt den Antworten von Jev je Frage, veröffentlicht mit Zustimmung von TypeSafe vom 10. Oktober 2026 (Nutzungshinweis). Gemessen haben wir noch unter seinem früheren Namen jev-match-bench, die Messdateien liegen unverändert in lab-bench. Die Fassung pv1 enthält vier Ausschreibungen und acht erfundene Lebensläufe, jeweils deutsch und englisch. Drei Ausschreibungen stammen wörtlich aus den Beispielen des Projekt-Abgleichs, auch sie sind erfunden. Daraus entstehen zehn Paare: vier passende, drei teilweise passende und drei unpassende. Die Fragen stammen unverändert aus dem Projekt-Abgleich auf meiner Website.
Diesen Test und drei weitere zeigt das Labor auf einer eigenen Seite, jeweils mit Frage, Daten, Ergebnis und dem Plan für die nächsten Tests: Gemessen im Prüfstand.
Wie ein Sprachmodell gegen Jev antreten kann
Ein Sprachmodell schreibt Text weiter, hat aber für jeden möglichen nächsten Wortteil eine Wahrscheinlichkeit, und die lässt sich auslesen. Jede Frage geht einzeln an das Modell, die Antworten stehen darunter als A, B, C. Wir schalten den Denkmodus ab und geben den Anfang der Antwort vor, damit als Nächstes der Buchstabe kommen muss. Die Wahrscheinlichkeiten der Buchstaben teilen wir durch ihre Summe, so haben sie dieselbe Form wie Jevs Antwort. Diese Summe nennen wir Masse. Ist sie klein, wollte das Modell lieber etwas anderes schreiben, und die umgerechnete Sicherheit täuscht.
Was dabei ungleich bleibt
Fälle, Wertung und Wortlaut der Fragen sind für alle Modelle gleich. Die Methodenbeschreibung des Prüfstands nennt 14 Punkte, die ungleich bleiben. Die wichtigsten:
- Jev bekommt eine Anfrage je Zeile, die lokalen Modelle eine je Frage, in einer Textform mit Systemtext von uns.
- Jev gibt seine Wahrscheinlichkeit selbst aus, bei den lokalen Modellen lesen wir sie aus den 20 wahrscheinlichsten Wortteilen.
- Winnow-12B und Shisa DE-1 liefen nicht in ihrem eigenen Format. Shisa DE-1 lief zudem als 4-Bit-Fassung eines Dritten statt in 16 Bit. Wie viel seines Abstands bei der Pflicht daran liegt, können wir nicht trennen.
- Jev ist laut TypeSafe vor allem auf Englisch trainiert, die Hälfte unserer Zeilen ist deutsch.
Jede Zahl in diesem Artikel gilt für das jeweilige Modell in unserem Prüfstand, mit dieser Kompression, am 1. Oktober 2026, bei GLiNER am 8. Oktober 2026.
Wie sicher sich ein Modell gibt, ist noch keine Kalibrierung. Die gewählte Antwort erreicht 0,99 oder mehr bei diesem Anteil der 1575 Fragen: Qwen3-32B 62,7 Prozent, Winnow-12B 57,3, Shisa DE-1 24,0, Jev 22,8, Qwen3.8-27B 14,9. Qwen3-32B trifft zugleich die Stufe am schlechtesten. Ganz vergleichbar sind die Anteile nicht, denn Jev rundet auf zwei Stellen.
Quellen
Alles Öffentliche am 1. und 2. Oktober 2026 abgerufen, die Modellkarten von Fastino am 8. Oktober 2026.
- Der Testfall: Projekt-Abgleich auf mboiman.github.io
- Winnow-12B, Modellkarte und Gewichte: huggingface.co/EldanRing/Winnow-12B, Server: github.com/EldanRing/winnow-inference
- Qwen3.8-27B: huggingface.co/Qwen/Qwen3.8-27B, in Ollama: ollama.com/library/qwen3.8
- Qwen3-32B: huggingface.co/Qwen/Qwen3-32B
- Shisa DE-1: huggingface.co/shisa-ai/shisa-de-1, quantisiert: huggingface.co/mradermacher/shisa-de-1-GGUF
- Jev, Vorstellung durch TypeSafe: typesafe.ai/blog/introducing-system-one-models-and-jev, Dokumentation: docs.typesafe.ai, Datenschutzerklärung mit dem Standort USA: typesafe.ai/legal/privacy-policy
- GLiNER2.5 Decide, Modellkarten mit Fastinos Vergleichstabelle: huggingface.co/fastino/GLiNER2.5-Decide-1B, huggingface.co/fastino/GLiNER2.5-Decide, huggingface.co/fastino/GLiNER2.5-multi-Decide
- TypeSafes Adapter für Sprachmodelle: github.com/typesafe-ai/system-one-adapter-python
- Unsere früheren Messungen: Jev im Praxistest, Laya gegen Jev
Alle Messwerte stammen aus unseren Läufen am 1. Oktober 2026 mit dem Prüfstand jev-match-bench, Fassung pv1, Stand Commit 43c39f8. Jev 1.13.0 (jev-1.13.0) lief über die TypeSafe-API, die lokalen Modelle auf einer RTX 4090 mit Ollama 0.30.6, Qwen3.8-27B mit 0.35.0. Die Richter waren Claude Opus (claude-opus-5-5) am 1. Oktober, Claude Sonnet (claude-sonnet-5-5) und Claude Fable (claude-fable-5-1) am 2. Oktober 2026. GLiNER lief am 8. Oktober 2026 mit gliner2 2.0.0 auf derselben RTX 4090, Stand Commit 2024c2c.
Im Prüfstand unter results/pv1/ steht die Gegenprüfung mit allen 61 Streitfällen (crosscheck.md). Daneben liegen die Quoten und p-Werte (score-*.md, significance-*.md), der Messaufbau mit allen 14 ungleichen Punkten (method.md) und die Übereinstimmung mit Jev (report.md). Alles zu GLiNER, auch die acht Varianten, die hier fehlen, steht in gliner.md, der Messaufbau in bench/run-gliner.py. Die abgestimmte Referenz liegt in reference/pv1/adjudicated-a.de.jsonl. Zeit und Kosten je Zeile haben wir am 2. Oktober 2026 aus den Dateien des ersten Laufs nachgerechnet (speed-cost.md), den Preis von Jev aus TypeSafes Modellübersicht vom selben Tag.