2024 haben wir eine kleine Textanalyse-App gebaut. Man gab ihr einen Text oder die Adresse einer Webseite, und sie zeigte, was darin steckt: Stimmung, Aufgaben, Termine, Beteiligte, Kennzahlen, Risiken. Die App ist nicht mehr online. Wir lassen den Artikel trotzdem stehen. Die Idee ist heute selbstverständlicher als damals, und an der App sieht man, wie wenig Technik dafür nötig ist.
Stand 3. Oktober 2026: Bis heute standen hier eine eingebettete Live-Demo und ein Text, der mehr versprach, als die App konnte. Beides ist ersetzt. Was jetzt hier steht, haben wir aus dem Quellcode der App rekonstruiert.
Wie sie gebaut war
Die ganze Analyse steckte in einem einzigen Prompt, also einer schriftlichen Anweisung an das Modell. Die App schickte den Text an ein Sprachmodell bei Azure OpenAI und verlangte vierzehn Felder zurück. Die Antwort kam als reines JSON, ein Textformat, das Programme direkt einlesen können. Ein eigenes Training oder ein angepasstes Modell gab es nicht. Kam der Text von einer Webseite, lud die App die Seite vorher und löste den Text aus dem HTML heraus.
Der Kern des Prompts sah so aus, gekürzt auf die Struktur:
{
  "Gefühle": {},
  "Klassifikation": "",
  "Aufgaben": { "hoch": [], "mittel": [], "niedrig": [] },
  "Termine": [],
  "Priorität": {},
  "Inhalt": [],
  "Ziel": "",
  "Stakeholder": [],
  "KPIs": [],
  "Automatisierungspotenzial": [],
  "Datenquellen": [],
  "Technologien": [],
  "Risiken": [],
  "Nächste_Schritte": []
}
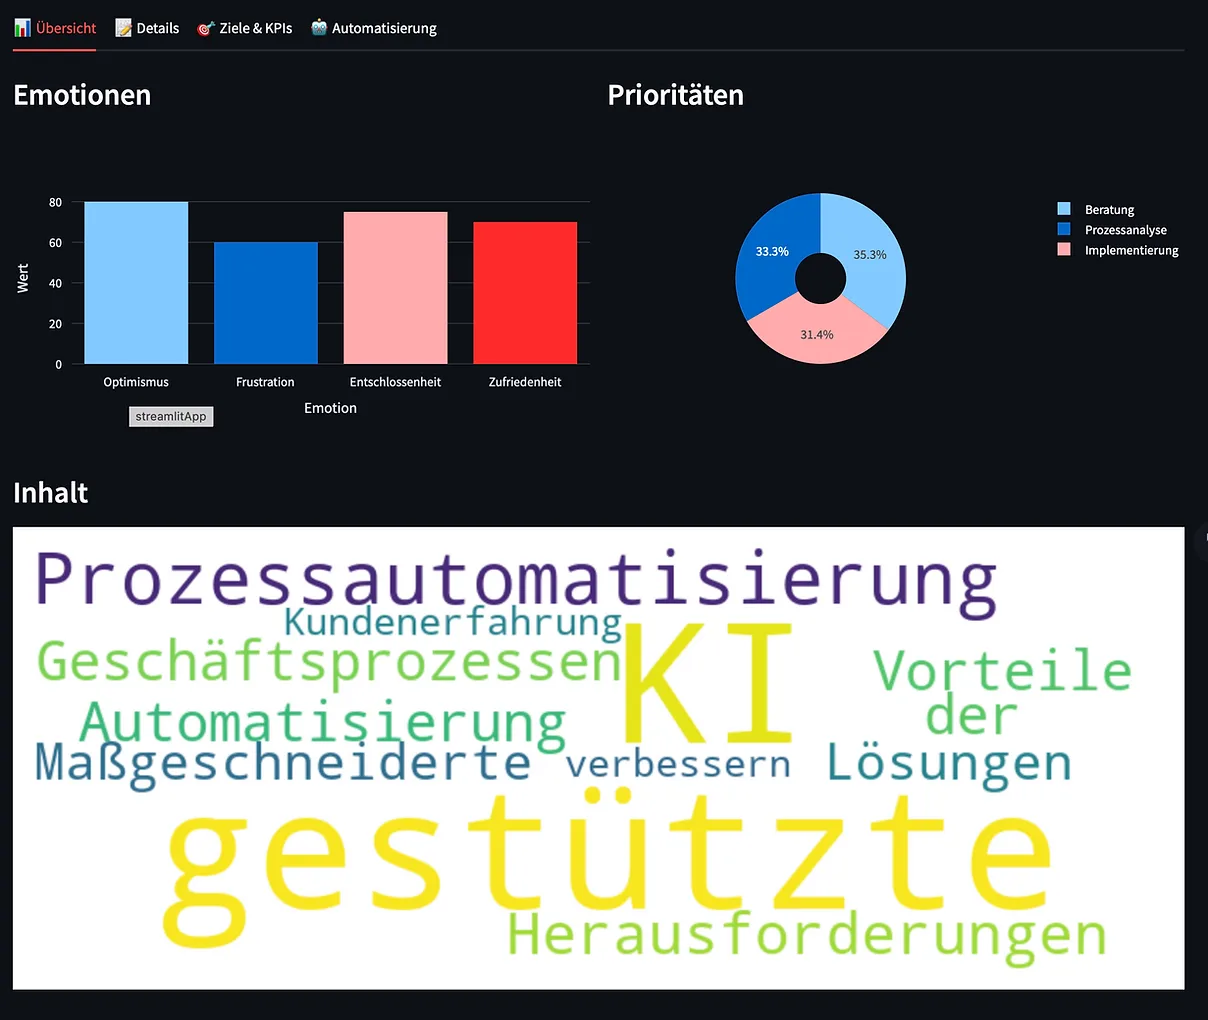
Alles Weitere war Darstellung. Die Oberfläche war mit Streamlit gebaut, einem Python-Werkzeug für schnelle Web-Oberflächen, und verteilte die Felder auf vier Reiter: Emotionen als Balken, Prioritäten als Ring, die Schlüsselthemen als Wortwolke, dazu Listen für Aufgaben, Termine, Kennzahlen und Risiken.
So sah das aus
Was daran interessant bleibt
Ein Text ist für ein Programm erst einmal nur eine Zeichenkette. Sobald ein Sprachmodell daraus Felder macht, kann Code damit arbeiten, zum Beispiel Aufgaben nach Priorität sortieren oder Termine in einen Kalender legen. Die App selbst ging nicht so weit. Sie hat die Felder nur angezeigt, und schon das brauchte nicht mehr als einen Prompt und ein paar Diagramme.
Die App hatte klare Schwächen. Das Modell lieferte gelegentlich kein gültiges JSON, und die App zeigte dann nur eine Fehlermeldung. Ob ein Feld stimmte, prüfte niemand. Eine Zahl wie „Optimismus 80“ sah präziser aus, als sie war.
Im Labor gehen wir die Aufgabe anders an. Statt ein Modell um vierzehn Felder auf einmal zu bitten, stellen wir einzelne Fragen mit festgelegter Antwortform. Die Antworten messen wir gegen bekannte Werte. Wie das aussieht, zeigt der Versuchsstand Jev liest mit: Dort liest ein Modell Testrechnungen aus der XRechnung-Testsuite. Wir messen, ob es Angaben findet, die nur im Freitext stehen und im Strukturfeld fehlen.
Texte auswerten in Ihrem Unternehmen
Welche Angaben in Ihren Texten stecken und wie man sie prüfbar herausholt, klären wir im Gespräch. Bringen Sie dafür gern ein paar typische Beispieltexte mit.